

Você já parou para pensar em quantas decisões existem entre ter uma base de dados e chegar a um resultado de pesquisa? E se pesquisadores diferentes analisassem o mesmo problema, será que encontrariam a mesma resposta?
É justamente isso que este paper investiga. Os próprios autores começam com uma frase que resume bem a questão: “Researchers make hundreds of decisions about data collection, preparation, and analysis in their research.” São centenas de decisões, e muitas nem aparecem no artigo publicado. A pergunta é: quanto essas escolhas influenciam o resultado final?
📄 O paper da semana
Huntington-Klein e coautores investigam essa questão em The Influence of Hidden Researcher Decisions in Applied Microeconomics, publicado na Economic Inquiry, em 2021. Acesse a versão gratuita no IZA. O artigo está em inglês.
Os autores usam um desenho conhecido como many-analysts, no qual diferentes pesquisadores analisam o mesmo problema de forma independente. Dois estudos causais publicados foram simplificados e replicados por sete pesquisadores cada.
Vamos olhar de perto o primeiro estudo, baseado em Black et al. (2008), que investiga o efeito das leis de escolaridade obrigatória sobre a gravidez na adolescência, usando dados do Censo americano, efeitos fixos de estado e coorte e variações nas leis estaduais.
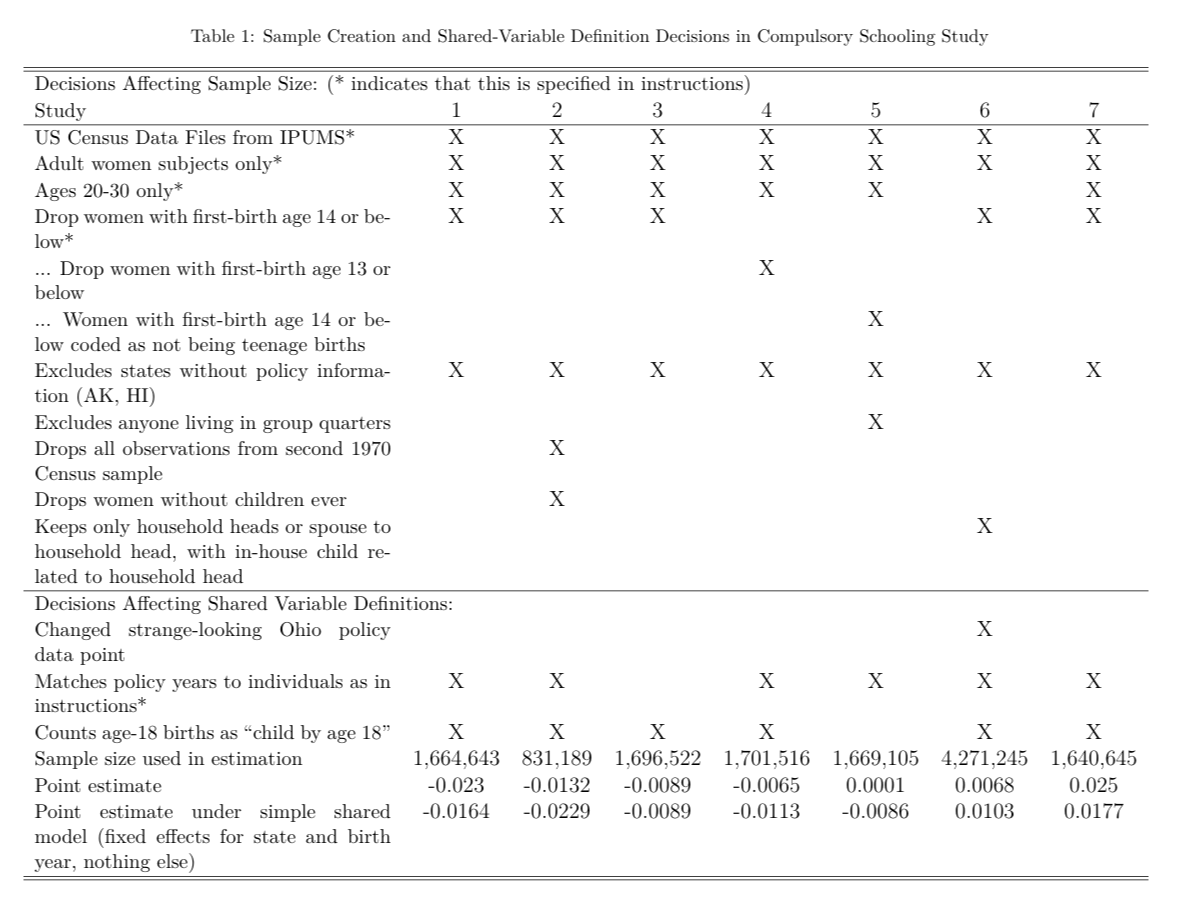
O que a Tabela 1 revela?
Algumas regras eram iguais para todos: usar os dados do IPUMS, considerar apenas mulheres e excluir os estados sem informação sobre a política. Até aí, tudo certo. Mas, na hora de preparar os dados, as escolhas começaram a divergir.
-
O corte de idade. As instruções pediam mulheres de 20 a 30 anos. A replicação 6 não aplicou esse filtro e terminou com 4.271.245 observações, enquanto as demais ficaram entre aproximadamente 1,6 e 1,7 milhão.
-
O que fazer com os nascimentos muito precoces? A orientação era excluir mulheres que tiveram o primeiro filho aos 14 anos ou menos. A replicação 4 excluiu apenas as que tiveram filhos até os 13 anos. Já a replicação 5 manteve essas mulheres e as classificou como se não tivessem tido gravidez na adolescência.
-
Decisões que não estavam nas instruções. A replicação 2 excluiu a segunda amostra do Censo de 1970 e as mulheres sem filhos, chegando a 831.189 observações, a menor amostra entre as sete. A replicação 5 excluiu moradoras de domicílios coletivos. A 6 considerou apenas chefes de domicílio ou cônjuges com filhos no domicílio.
-
A definição da variável dependente. A replicação 5 não contabilizou nascimentos aos 18 anos exatos como casos de filhos até os 18 anos.
-
E até um possível erro na base de políticas. Ohio aparece com escolaridade obrigatória de 8 anos em 1944 e de 18 anos nos demais anos. Os próprios autores levantam a possibilidade de erro de digitação. Só a replicação 6 corrigiu o valor.
O resultado? Nenhum par de pesquisadores chegou ao mesmo tamanho de amostra. E as estimativas pontuais variaram de −0,023 a +0,025, com resultados que mudaram até de sinal.
Ou seja, dependendo de como os dados foram preparados, a conclusão sobre o efeito da política poderia ser diferente.
Mas será que a diferença não está só no modelo econométrico?
Boa pergunta. Os autores também investigaram isso.
Eles aplicaram exatamente o mesmo modelo às sete bases: efeitos fixos de estado e ano de nascimento, sem outros controles. Mesmo assim, as estimativas variaram de −0,0229 a +0,0177. O sinal continuou inconsistente.
E tem um detalhe ainda mais interessante.
As replicações 1 e 7 marcaram exatamente as mesmas decisões de construção da amostra na Tabela 1. Mesmo assim, terminaram com 1.664.643 e 1.640.645 observações, uma diferença de quase 24 mil registros.
Quando os autores aplicaram o mesmo modelo às duas bases, encontraram estimativas de −0,0164 e +0,0177. Magnitudes parecidas, mas sinais opostos.
Pense nisso: dois pesquisadores poderiam descrever seus procedimentos da mesma maneira em um artigo e, ainda assim, chegar a conclusões diferentes.
Na decomposição das diferenças entre estimativas, fixar o modelo reduziu a soma dos quadrados das diferenças em 84%. Fixar a amostra reduziu em 83%. Isso mostra que as decisões sobre o modelo e a construção dos dados têm importância semelhante nesse exercício.
E o que isso tem a ver com o erro-padrão?
O erro-padrão nos ajuda a avaliar a incerteza de uma estimativa. Mas existe uma fonte de incerteza que ele pode não capturar: a diferença entre as decisões que pesquisadores tomam ao conduzir uma análise.
No estudo sobre escolaridade, o erro-padrão médio reportado correspondeu a apenas 25,1% do desvio-padrão das estimativas entre replicações. No estudo sobre seguro-saúde, essa proporção foi de 32,5%.
A conclusão dos autores é que os erros-padrão convencionais deixam de fora uma fonte importante de variação nos resultados: aquela que surge das escolhas feitas durante a pesquisa.
Tá, mas como isso aparece no seu trabalho?
Imagine que você quer comparar o Ideb das escolas ao longo do tempo, mas algumas não têm nota em determinados anos.
O que você faria?
Excluiria essas escolas da análise? Reduziria o período observado? Investigaria por que as notas estão faltando? Cada decisão pode mudar quais escolas entram na comparação e, consequentemente, os resultados encontrados.
Não significa que exista uma única escolha correta para todos os casos. Significa que precisamos entender o que cada decisão implica e deixar isso transparente.
Uma sugestão dos próprios autores é tornar o Data Appendix, ou apêndice de dados, um item padrão dos artigos. Na prática, vale documentar no código ou em um diário de pesquisa o que foi decidido, por que a decisão foi tomada e quantas observações entraram ou saíram em cada etapa.
E calma: o artigo analisa dois estudos, com magnitudes diferentes de variação. Os autores também ressaltam que essas escolhas não são necessariamente erros, muito menos evidência de fraude. O ponto é que a incerteza sobre um efeito pode ser maior do que o erro-padrão publicado faz parecer.
E quero saber de você:
Se estivesse fazendo essa pesquisa, qual decisão da Tabela 1 você tomaria de outra forma? E por quê?
Se está começando agora, vale pensar em um exemplo mais próximo: o que você faria com as escolas sem nota no Ideb?
Compartilhe sua resposta e aproveite para comentar a escolha de outra pessoa. Afinal, discutir as decisões também faz parte de aprender econometria.

Entre para comentar